
在美团的一些大型业务开发中,团队会认为系统已经难以继续维护,常被归因于代码复杂度高。后台业务的复杂度也不低,却较少出现同样的反馈。可维护性并不完全由系统的客观复杂度决定,还和维护者的知识、团队变化及业务变化有关。例如:
- 接手前人的项目后,新的维护者可能认为可维护性差并启动重构,而上一任维护者没有这个判断。
- 有人认为 React 项目复杂、难以开发维护,React core team 的成员未必有相同感受。
- 架构师离开、团队成员更替后,原有系统会变得难以维护。
- 业务支持多个业态,或业务转向新方向时,局部复用的系统可能难以继续维护。
影响可维护性的因素
这些情况可以从下表的四个维度分析,链接是我对相应问题的具体思考:
| 客观情况 | 人相关 |
|---|---|
| 业务复杂度:《🐣系统中复杂度体现在哪些方面》《🐣为什么复杂的业务不好做》 | 技能:拥有一定深度和广度 《✅如何看待技术深度与广度》 |
| 代码与架构:《🐣如何做好前端架构》 | 熟悉程度:(时间 +意愿)*理解力/频次 |
业务复杂度无法改变;熟悉程度也需要投入精力,即时间和意愿。以优选项目为例,可以从以下方面分析其难以维护的原因:
- 熟悉程度低:为了赶排期,常协调其他人开发原本不负责的业务功能,团队对项目的平均熟悉度偏低。
- 架构不合理:过去每周2大迭代+3迭代,还要排查很多线上问题,团队没有足够精力完成周全的技术设计。
- 业务复杂度:团长、用户、新人、老客、促销、活动等同时存在,业务 case 相对复杂。
- 技能:低职级同学承担主要开发,KP 更多精力用于排查线上问题,高职级同学事务性工作多,项目中的技能投入偏低。
这些因素会形成图中红色部分所示的负向循环:
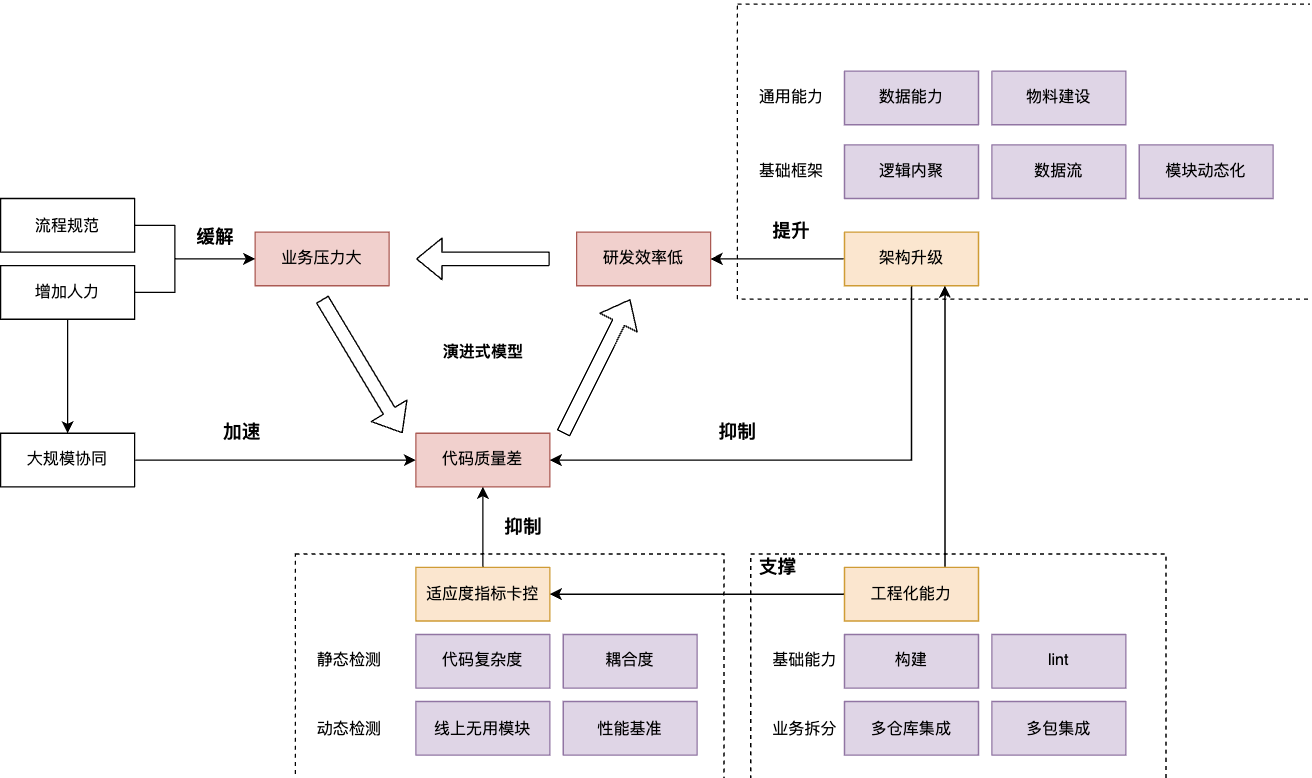
提高可维护性的办法
(1) 业务复杂度
技术无法消除由商业行为带来的业务复杂度。业务包含的信息越多,系统需要处理的复杂度也越高。架构设计可以拆分复杂度,使不同成员只处理各自范围内的业务;系统主R仍需汇总被拆分的信息。这些工程方法降低了人的理解成本,同时会增加系统实体数量。可维护性因此依赖于对业务的理解,以及与之对应的代码和架构设计。
(2) 代码与架构
2.1. 架构如何服务业务
开发时不应教条地套用设计模式和架构模型。架构的作用是将业务抽象为技术实现。抽象是否合适,可以观察适应度函数的曲线是否贴合业务的真实复杂度;抽象不合适时,简单页面也可能难以理解。详见《🐣如何做好前端架构》。
架构还用于拆分业务模块。确定开发一个模块所需的最小知识,可以减少开发者需要同时理解的内容;与当前模块无关的部分不应轻易暴露。
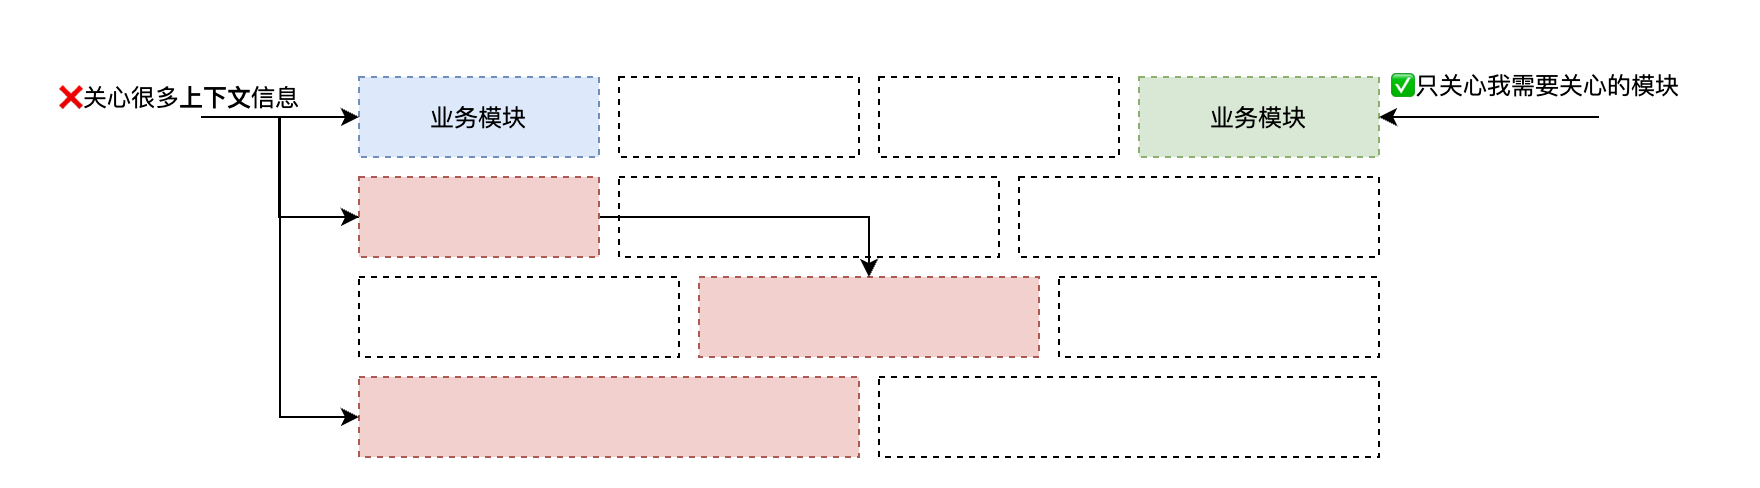
前端项目通常有较明确的分层。例如,一个业务中的前端项目会分为容器层、基础能力层(网络,日志,安全)、物料层、业务能力层(登录,支付,购物车)等。具体业务模块的抽象仍可能不足。当前讨论较多的是数据流和框架(React/Vue),它们是实现手段,不能直接完成业务逻辑的抽象。服务端已有六边形架构、DDD 等抽象方式,前端也需要继续探索业务抽象。
架构还应包含文档、测试等配套设施,帮助维护者理解业务和代码。
2.2. 衡量代码可维护性
过去前端复杂度相对较低,框架能够解决一部分维护问题,因此这一问题受到的关注较少。近几年出现了很多巨石应用,可维护性开始在一些业务团队中被反复讨论。现阶段通常用质量指标和主观感受衡量可维护性,后者缺少稳定的比较依据。我们希望得到适应度函数(Fitness Function)Fi:Maintainable = Fi(Feature)。业务功能变化时,可维护性的变化也应尽可能贴合。这里的“贴合”指《🐣系统中复杂度体现在哪些方面》中提到的三点:
- 不要修改放大 (Change Amplification)
- 减轻认知负担 (Cognitive Load)
- 减少未知的未知 (Unknown Unknown)
Feature 的变化形式很多,业务逻辑也不总能按固定规则描述,因此无法正面求得Fi,只能通过侧面指标衡量。业界有很多理论(见备注),可以从两个方面观察:
源码方面
指标:LLOC
相比传统的 LOC,LLOC 受格式变化的影响更小。
// LOC 1
// LLOC2
if(true) console.log('hello');
// LOC 3或4
// LLOC 2
if(true) {
  console.log('hello');
}
指标:Halstead Complexity(HV) GitHub - aametwally/Halstead-Complexity-Measures: Calculate Halstead complexity software measures using ASTParser. These metrics are computed statically, without program execution.
指标:Cognitive Complexity (CC)
认知复杂度 中的两种方法有相同的圈复杂度,但理解控制流所需的成本不同:
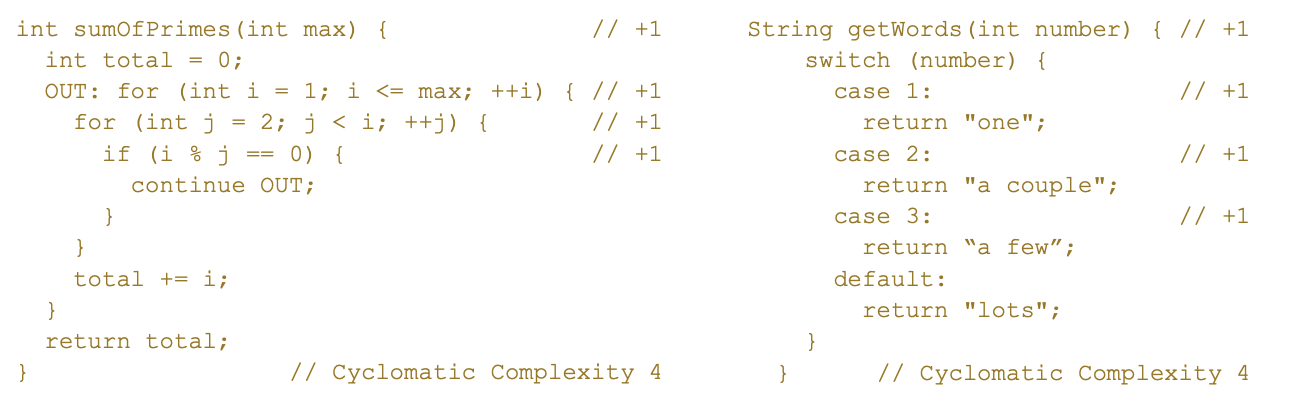
圈复杂度的数学模型为两种方法赋予相同权重。sumOfPrimes 的控制流比 getWords 更难理解。认知复杂性不再只用数学模型评估控制流,而是用一套规则将程序员对控制流的判断转化为数字。
代码中的一个 bad case 可以用认知复杂度衡量:
a && b //圈复杂度:2 ,认知复杂度:2
a && b && c && d // 圈复杂度:4 ,认知复杂度:2
a || b && c || d // 圈复杂度:4 ,认知复杂度:4
架构方面
内聚性、共生性(耦合)会在后续文章中单独展开。
指标函数
Maintainability Index:由 Paul Oman and Jack Hagemeister 在1992年提出,它是若干种度量的混合,包括 HV, CC 以及 LLOC 三个不同指标,原始公式为:MI=171−5.2lnV−0.23G−16.2lnL SEI 的衍生版本 MI=171−5.2log2 V−0.23G−16.2log2 L+50sin(2.4C)
还有 Visual Studio 衍生版本, Radon 衍生版本等等。
这些函数可以近似计算适应度指标。持续观测业务代码在迭代过程中的指标变化,可以判断指标是在变好还是变差,并作为代码卡控的依据。
(3) 熟悉程度
可以通过流程规范提高团队对代码的平均熟悉水平,例如锁定主R、降低迭代频次、提高系统设计细节要求。
(4) 技能
这部分取决于岗位胜任度,可以使用选用育励汰等方法论。
