
神经网络入门:从感知机到反向传播
本文是「零基础学大模型原理」系列的第 1 篇。这个系列记录一个没有任何机器学习背景的工程师,在 ChatGPT 发布之后从零补原理的过程。 神经网络入门:从感知机到反向传播(本文)
2022 年 11 月 30 日 ChatGPT 上线,之后两周我的推特时间线几乎全是它的信息。得知它背后是 GPT-3.5后我把 GPT-3 的论文翻出来想了解原理,但读完摘要后基本无法继续:预训练、上下文学习、few-shot 等词都能查到解释,连起来却不知道这个系统如何形成。本着还是得自己动手体验一下,于是从「神经网络到底怎么训练」开始学习。这篇不需要机器学习前置知识,读者能看懂几行 Python 即可。
训练如何调整模型参数
介绍大模型的文章常说「模型在海量文本上训练」。对有工程背景但没有机器学习背景的人,这句话里的每个词都需要解释一下:模型的「参数」是什么?「训练」是如何调整这些参数的,按什么标准调整?
这一周看完 3Blue1Brown 神经网络系列的前四集和 Michael Nielsen 在线书的前两章后,我理解了这条计算链路。
训练是一个数值优化循环:先定义一个函数,把模型当前的误差算成一个数(损失);再算这个数对每个参数的变化率(梯度);然后让参数沿使损失减小的方向移动一小步,重复多次。反向传播按链式法则从后往前计算这些变化率,以避免重复计算。
假设我们要训练一个最简单的”模型”:给定温度 ,预测用电量 ,模型就是一条直线 。这就是只有 2 个参数( 和 )的神经网络的最原始形态。
对于有工程背景的人,最准确的类比是:模型是一段带待定常量的程序。上面这个”模型”程序里, 是输入,、 是编译期不填、需要事后确定的常量。所谓”训练”,就是在给这段程序”调参”。GPT 这类大模型本质上也是一个函数,只是这个函数大约有数千亿个这样的参数,它们以矩阵形式组织在几十层变换里。每个参数就是一个浮点数,没有任何语义,纯粹是数字。模型的全部”知识”都以这些数字的大小形式存在,这就是”参数”的含义。
“训练按什么标准调整”:把”好不好”变成一个数
既然要调整参数,就需要一个标准来判断当前参数是好是坏。做法是定义一个损失函数 :输入是参数,输出是一个标量——当前参数在训练数据上错得有多离谱。
以上面直线为例,给定一批真实数据点 ,一个常用的损失是均方误差:
注意三件事:
- 损失是一个关于参数的函数,与输入数据无关的部分都已经代入成了具体数字。所以”调参”在数学上就等价于:在这个(可能几千亿维的)函数上找一个极小值点。
- 它是标量,这样才能比较” 比 好”。所有”判断好坏”的主观标准,都被压缩进这一个数。
- 训练数据越多、损失定义越合理,这个数逼近”真实泛化能力”的程度越高——但注意它本身只是在已见数据上的误差,这是过拟合问题的根源。
怎么调整:梯度告诉你”每个参数往哪里调”
现在问题变成纯粹的数值优化:最小化 。直接求解析解(令导数为零)在千亿参数规模下不可行,所以用梯度下降。
核心事实是:在点 处,函数上升最快的方向是梯度 。直觉: 回答的问题是——“如果我把 单独增大一点点,损失会增大多少?“。这个比值就是变化率,而梯度的每个分量就是这个函数对每个参数的偏导数。
于是更新规则是反方向走一小步:
其中 叫学习率(learning rate),是人为设定的步长。“沿使损失减小的方向移动一小步,重复多次”说的就是这件事。按我们的例子:
- 如果 ,说明 增大损失变大 → 应该把 减小一点;
- 如果 ,说明 增大损失变小 → 应该把 增大一点。
用 JS 写出来就是一个完整的训练循环:
注意这个循环的结构正是前面说的三步:前向算出预测 → 算出损失对各参数的梯度 → 沿反方向更新参数。
// 数据:(温度, 用电量)
const data = [[20, 35], [25, 52], [30, 70], [35, 91]];

let w = 0, b = 0;          // 参数:初始为 0
const lr = 0.001;          // 学习率:每一步走多远

for (let epoch = 0; epoch < 5000; epoch++) {
  let dL_dw = 0, dL_db = 0; // 梯度分量,初始化为 0

  for (const [x, y] of data) {
    const pred = w * x + b;      // 前向:模型预测
    const err  = pred - y;       // 误差
    // dL/dw 和 dL/db 来自对 (pred - y)^2 求导
    dL_dw += 2 * err * x;
    dL_db += 2 * err;
  }
  dL_dw /= data.length;
  dL_db /= data.length;

  // 沿梯度反方向走一小步
  w -= lr * dL_dw;
  b -= lr * dL_db;
}
console.log(`y = ${w.toFixed(2)}x + ${b.toFixed(2)}`);
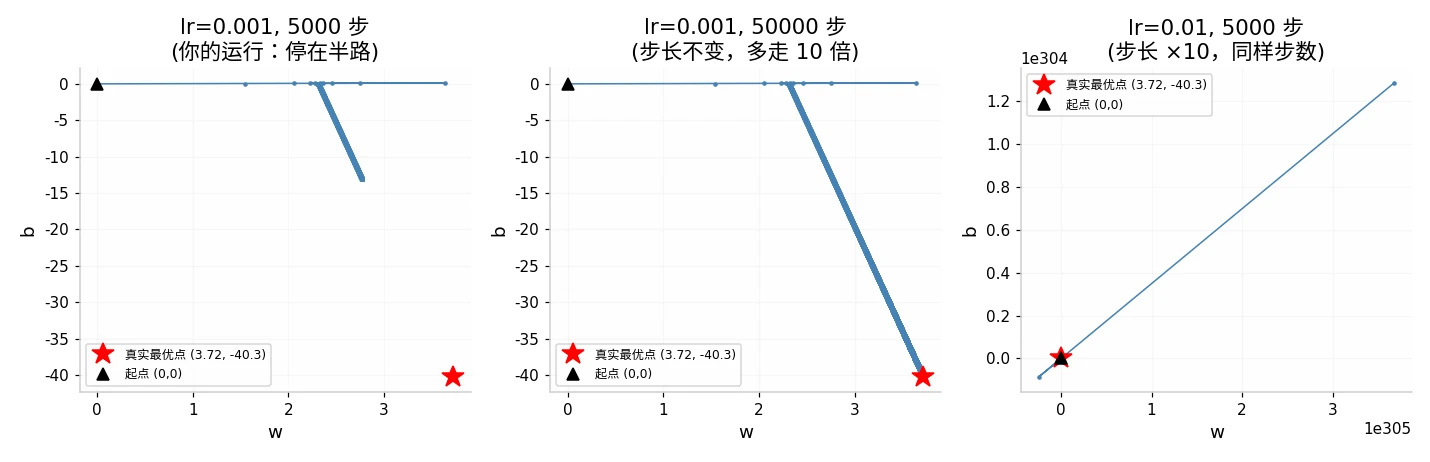
下图是程序运行不同部署 或者 步长不一样的情况下的运行结果
这张图把梯度下降的三个关键现象全展示出来了(左到右):
- 左图(我的运行):轨迹从 出发,先沿 方向缓慢挪动。注意梯度分量 ,乘了 ,所以 方向的梯度大、动得快;而 方向的梯度没有 这个乘数,动得慢得多。5000 步后 到了 2.77,但 才 -13.13,整条路径还在朝红星走,只是没走完。
- 中图:步长 不变,迭代次数 ×10(5 万步),轨迹顺利到达 附近,损失从 30.3 降到 1.07。方向从来没错,只是原来给的时间不够。
- 右图:迭代不变,步长 ×10(),结果直接发散到 NaN。原因:步长超过了「谷底宽度」,每步都从谷底这一侧 overshoot 到另一侧,而且越跳越远——经典的梯度下降发散。函数值一度冲到 量级,浮点数直接溢出。
四、反向传播:链式法则如何省掉天文数字的计算
上面的例子只有 2 个参数,可以直接对损失解析求导。真实网络有几十层复合函数,比如第 3 层的输出是第 4 层的输入,第 4 层的输出又是第 5 层的输入:
损失对第 1 层参数的导数,按链式法则长这样:
关键洞察是:每个中间因子都会被多条路径反复用到。比如 既出现在对 的求导里,也出现在对 、 的求导里。
- 如果从前往后算(“前向模式”):每个参数的导数都要独立地把整条链乘一遍,参数量为 时,总计算量约为 层数,对千亿参数是天文数字。
- 反向传播(“反向模式”):从输出端开始,先算出 ,再乘一个雅可比矩阵得到 ,再依次往前推。每一层只需算一次,所有参数共享这些中间结果——总计算量大约只相当于前向计算的几倍,与参数数量无关。
这就是”从后往前计算以避免重复计算”的精确含义。它不是什么神秘算法,本质就是求导的链式法则配合动态规划式的记忆化:把沿链共用的中间导数缓存下来,一次反向传播就能同时得到所有参数的梯度。你在 3Blue1Brown 第 3、4 集看到的”误差沿网络逐层回传”,就是这个缓存从输出层流向输入层的过程。
五、总结
| 短语 | 含义 |
|---|---|
| “定义一个函数把误差算成一个数” | 损失函数 :标量化”当前参数有多差” |
| “这个数对每个参数的变化率” | 梯度 :损失对每个参数增加 1 单位时的敏感度 |
| “沿使损失减小的方向移动一小步” | :梯度下降更新 |
| “重复多次” | 迭代 + 分批数据(epoch / batch),直到损失收敛 |
| “反向传播按链式法则从后往前” | 反向模式自动求导,以 代价拿到全部参数梯度 |
最后补一句理解大模型的关键:“在海量文本上训练”意味着损失函数里那批 是万亿量级的真实语料,而”下一个词是什么”这个任务天然产生无限标注数据。优化的数学和上面 2 参数的直线一模一样,差别只在函数的深度和参数的个数——这也正是为什么这个简单的循环能扩展到千亿参数仍然 work。
参考资料
- 3Blue1Brown: Neural networks 系列视频,看了前四集:神经元结构、梯度下降、反向传播的直觉与链式法则。它适合需要复健数学的读者作为入门材料。
- Michael Nielsen: Neural Networks and Deep Learning,读了第一章和第二章。第一章讲感知机、sigmoid 神经元和网络结构,第二章完整推导了反向传播的四个公式,本篇的 numpy 代码按照其推导编写。
- Language Models are Few-Shot Learners(GPT-3 论文),这篇论文促使我从基础概念开始学习。本文写作时,其第二节我仍无法顺畅理解。
