
本文是「零基础学大模型原理」系列的第 3 篇。这个系列记录一个没有任何机器学习背景的工程师,在 ChatGPT 发布之后从零补原理的过程。
神经网络入门:从感知机到反向传播 词怎么变成向量:从 one-hot 到 Word2Vec Transformer 之前:RNN、seq2seq 与注意力机制(本文)
上一篇解决了「词怎么变成向量」:Word2Vec 把每个词压成几百维向量,语义关系变成向量空间里的几何关系。但那篇结尾留了两个问题:一个词只有一个固定向量,「苹果」在任何句子里都是同一个向量,一词多义无法处理;即使每个词都有向量,一句话仍是一串向量,「我打狗」和「狗打我」的词完全相同、意思相反,差别在顺序里。我看了一些资料反复出现 RNN、seq2seq、attention 这几个词,这两周我梳理了它们之间的关系。前置知识还是上一篇:知道词向量是什么就够。本文介绍 Transformer 出现之前的主流做法,读语言模型资料时会遇到它们。
先总结下
RNN / LSTM(2014 前后):按顺序一个词一个词读,把前一个词的信息传给下一个。能捕捉”猫追狗”和”狗追猫”的区别。缺点:句子一长,前面信息传到后面就淡了。
Transformer / BERT(2018 起):让每个词同时”看”句中所有其他词(注意力机制),距离再远也传得到。现在的主流。
句向量模型(如 SBERT):拿训练好的 BERT,加个池化层,直接输出整个句子的一个向量。语义搜索、句子比对都用它。
句子中的顺序信息
先明确问题。词向量解决了「词」的表示,但句子不是词袋。「我打狗」和「狗打我」由完全相同的三个词组成,把三个词向量相加后取平均,两句话得到相同的表示。模型要处理句子,需要按顺序读入词,并让后续计算能使用已经读过的信息。
这就是序列模型处理的问题。2014 前后,机器翻译常用 RNN(循环神经网络),再在其上使用 seq2seq 编码器-解码器结构和注意力机制。它们也是后来 Transformer 的前序方案。
RNN 按顺序更新隐状态
这里理解了一段时间,画了一个图如下
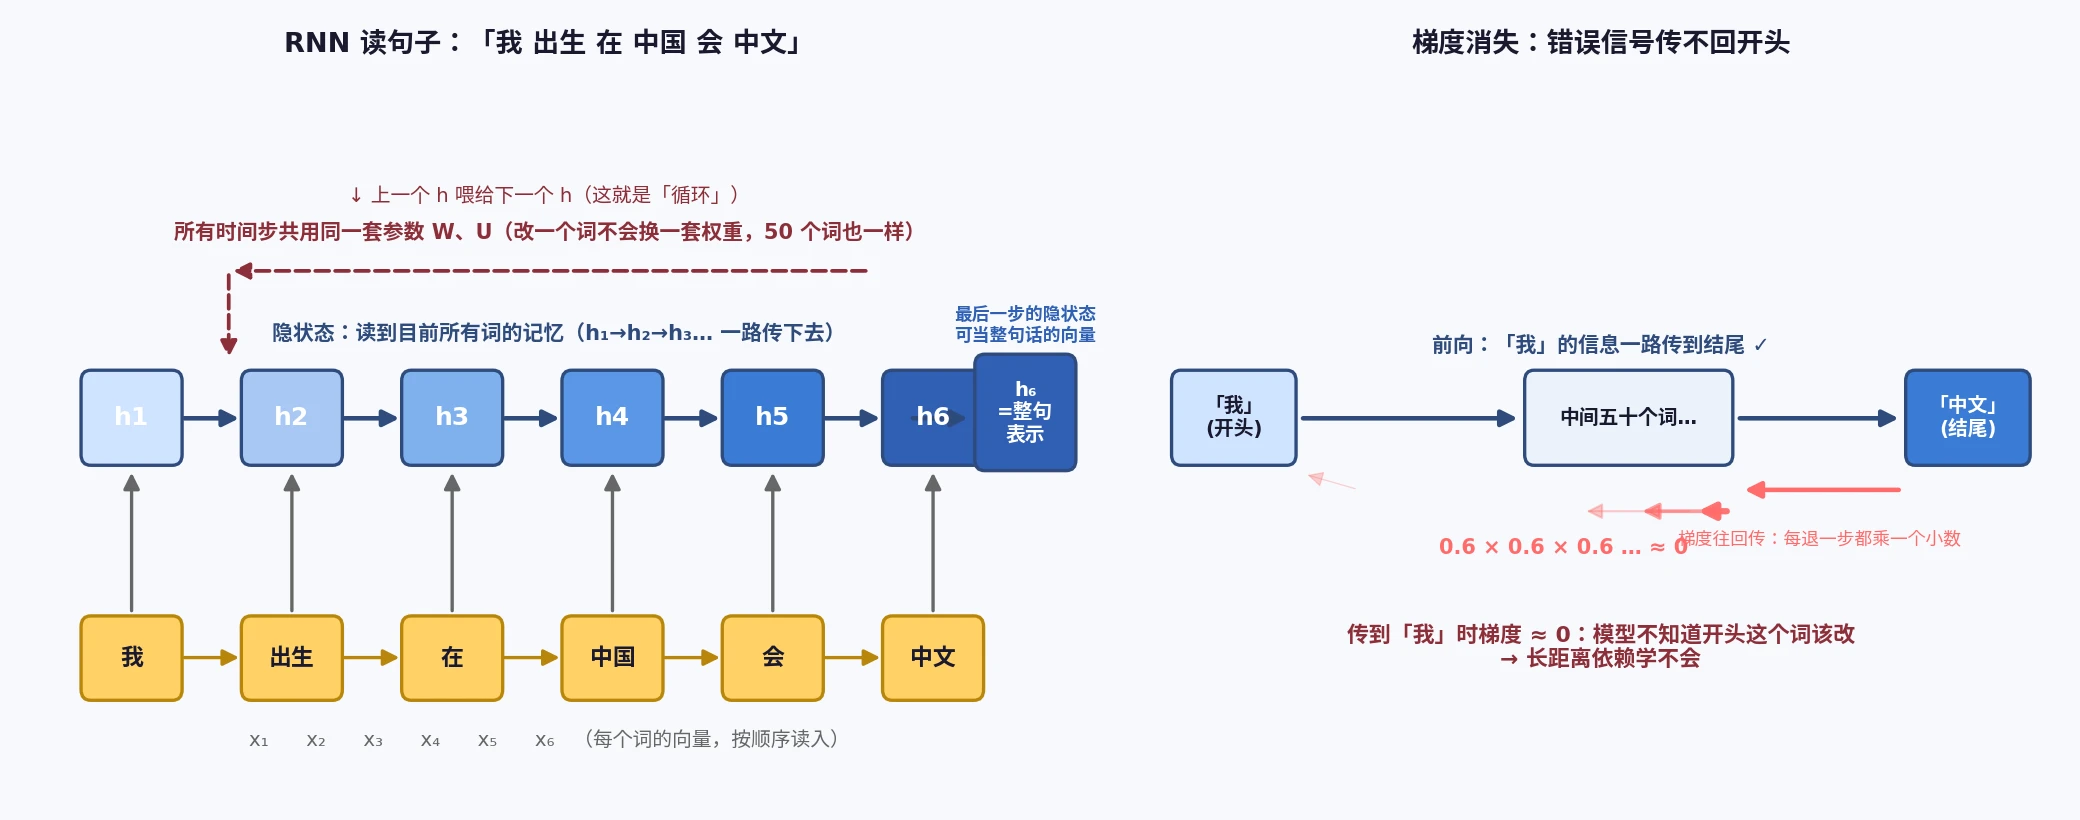
RNN 按顺序逐个读词,每读一个词就更新一次隐状态。形式上:
是第 个词的向量, 是读到前一个词为止的隐状态, 是更新后的隐状态。 和 是需要训练的参数,所有时间步共享同一套参数。读完整句话后,最后的 可作为整句话的压缩表示。
展开讲一下我的理解:
- 隐状态 h —— “读到现在的记忆”: 一个不断更新的向量。读「我」之后是 h₁(只装了一个词的信息);读「出生」之后是 h₂(装着”我 出生”);一路到 h₆,装着整句。看图左边蓝色方块链。
- 时间步 —— “读第几个词”: t = 1 就是读第 1 个词的那一步,t = 2 是第 2 步。所谓”梯度沿时间步传回去”,就是错误信号从结尾一步步倒着走回开头。
- 参数 W、U —— “两张调参表,全程共用”
- U 管”新进来的词怎么融进记忆”(h 与 x 的关系)
- W 管”上一步的记忆怎么带到下一步”(h 与 h 的关系)
关键:所有时间步共用同一套 W、U,所以 5 个词和 50 个词的句子不用改结构——参数数量与句长无关。
从工程实现看,它是一个循环:隐状态是循环中持续携带的变量,每轮迭代读入一个新元素并更新一次状态。参数在时间上复用,因此序列长度不同也能使用同一套参数,输入是 5 个词还是 50 个词都不需要改结构。
最朴素的 RNN 存在梯度消失和梯度爆炸问题。训练时,梯度要沿时间步传回去,每传一步都会乘以局部导数。连乘几十次后,靠前词对应的梯度可能指数级缩小到接近零,也可能增大到不稳定的范围。句子变长时,开头信息对结尾状态的影响可能变弱。「我出生在中国,……中间隔着五十个词……所以我会说中文」这类长距离依赖,朴素 RNN 往往难以学习。
LSTM 使用门控更新记忆
LSTM 是对此问题的工程解法。Hochreiter 和 Schmidhuber 在 1995 年提出它,同名论文于 1997 年发表。它把状态分成两部分:细胞状态用于携带长期信息,隐状态作为对外暴露的工作状态。三组门控制信息流动:
- 遗忘门:控制保留多少旧的细胞状态
- 输入门:控制写入多少当前候选信息
- 输出门:控制向下一时间步输出多少细胞状态
每个门通过 sigmoid 输出 0 到 1 之间的值,可视为连续的可学习系数。细胞状态在多个时间步之间传递,门决定保留、写入和输出的信息。细胞状态为梯度跨多个时间步传播提供了较直接的路径,减少了每一步都经过完整矩阵乘和非线性变换的情况,因此有助于学习长距离依赖;它不保证梯度在任意长度上都不会衰减或爆炸。
三个门和生成候选细胞状态的一层,共有四组参数,公式接近一页,我没有逐个推导。当时的判断是:LSTM 保留了顺序处理,并改善了较长句子上的学习条件。状态仍然按时间步依次更新。
seq2seq 的固定向量限制
Sutskever、Vinyals 与 Le 的 seq2seq 工作于 2014 年 9 月以 arXiv 预印本公开,后收录于 NIPS 2014。它使用多层 LSTM 构建编码器-解码器式的序列到序列机器翻译模型。编码器用 LSTM 逐词读取源语言句子,将最终状态作为句子表示;解码器用另一个 LSTM,根据这个表示逐词生成目标语言。每生成一个词,解码器将上一步生成的词和自身状态用于后续计算。这种方法使神经机器翻译获得了可用结果;在此之前,短语统计机器翻译是常用方案,规则和特征需要人工设计。
这个结构有一个限制:无论源句是 5 个词还是 50 个词,编码器的信息都集中在最后的固定长度向量中,解码器只能直接访问这个向量。Jay Alammar 的图解中,编码器和解码器之间只有这条信息通道。句子越长,单个向量需要编码的信息越多。Cho 等人的实验显示,基础编码器-解码器模型的翻译质量(BLEU 分数)会随句长增加而下降。Bahdanau 等人据此推测,将整句压缩为固定长度向量可能构成瓶颈,并用注意力机制缓解这一限制。
限制来自结构:整句话通过一个向量传递。替换 RNN 单元不能让解码器直接访问各个源词位置。
注意力让解码器访问编码器状态
Bahdanau 等人在 2014 年 9 月公开的 arXiv 初稿中,将软对齐注意力用于神经机器翻译;这项工作正式发表于 ICLR 2015。解码器在生成每个词时,都可以访问编码器所有时间步的隐状态,并按相关程度计算当前的上下文向量,而非只使用最后一个状态。
计算分三步。第一步是打分:用解码器的前一状态和编码器各位置的隐状态计算相关分数,原论文使用参数可学习的小型前馈网络。第二步是归一化:对所有分数做 softmax,得到和为 1 的权重,分数较高的位置权重较大。第三步是加权求和:用这些权重对各位置的隐状态加权求和,得到当前上下文向量,再将其用于解码器的状态更新和词预测。每一步解码都会重新计算权重,上下文向量也会变化。
Bahdanau 的编码器使用双向 RNN,每个位置的注释向量由从左到右和从右到左的隐状态拼接而成,因此包含该位置两侧的上下文。一词多义问题在这里有了初步回应:编码器各位置的隐状态不再是孤立词向量。以单向 RNN 为例,隐状态包含此前词的信息;双向 RNN 还包含后续词的信息,因此「苹果」在「吃苹果」和「苹果公司」中对应的状态会不同。词向量是静态的,隐状态依赖上下文。
手算注意力权重
用一个小例子说明计算过程。「我 爱 吃 苹果」翻译成 “I love eating apples”,看解码器生成最后一个词 “apples” 的那一步。
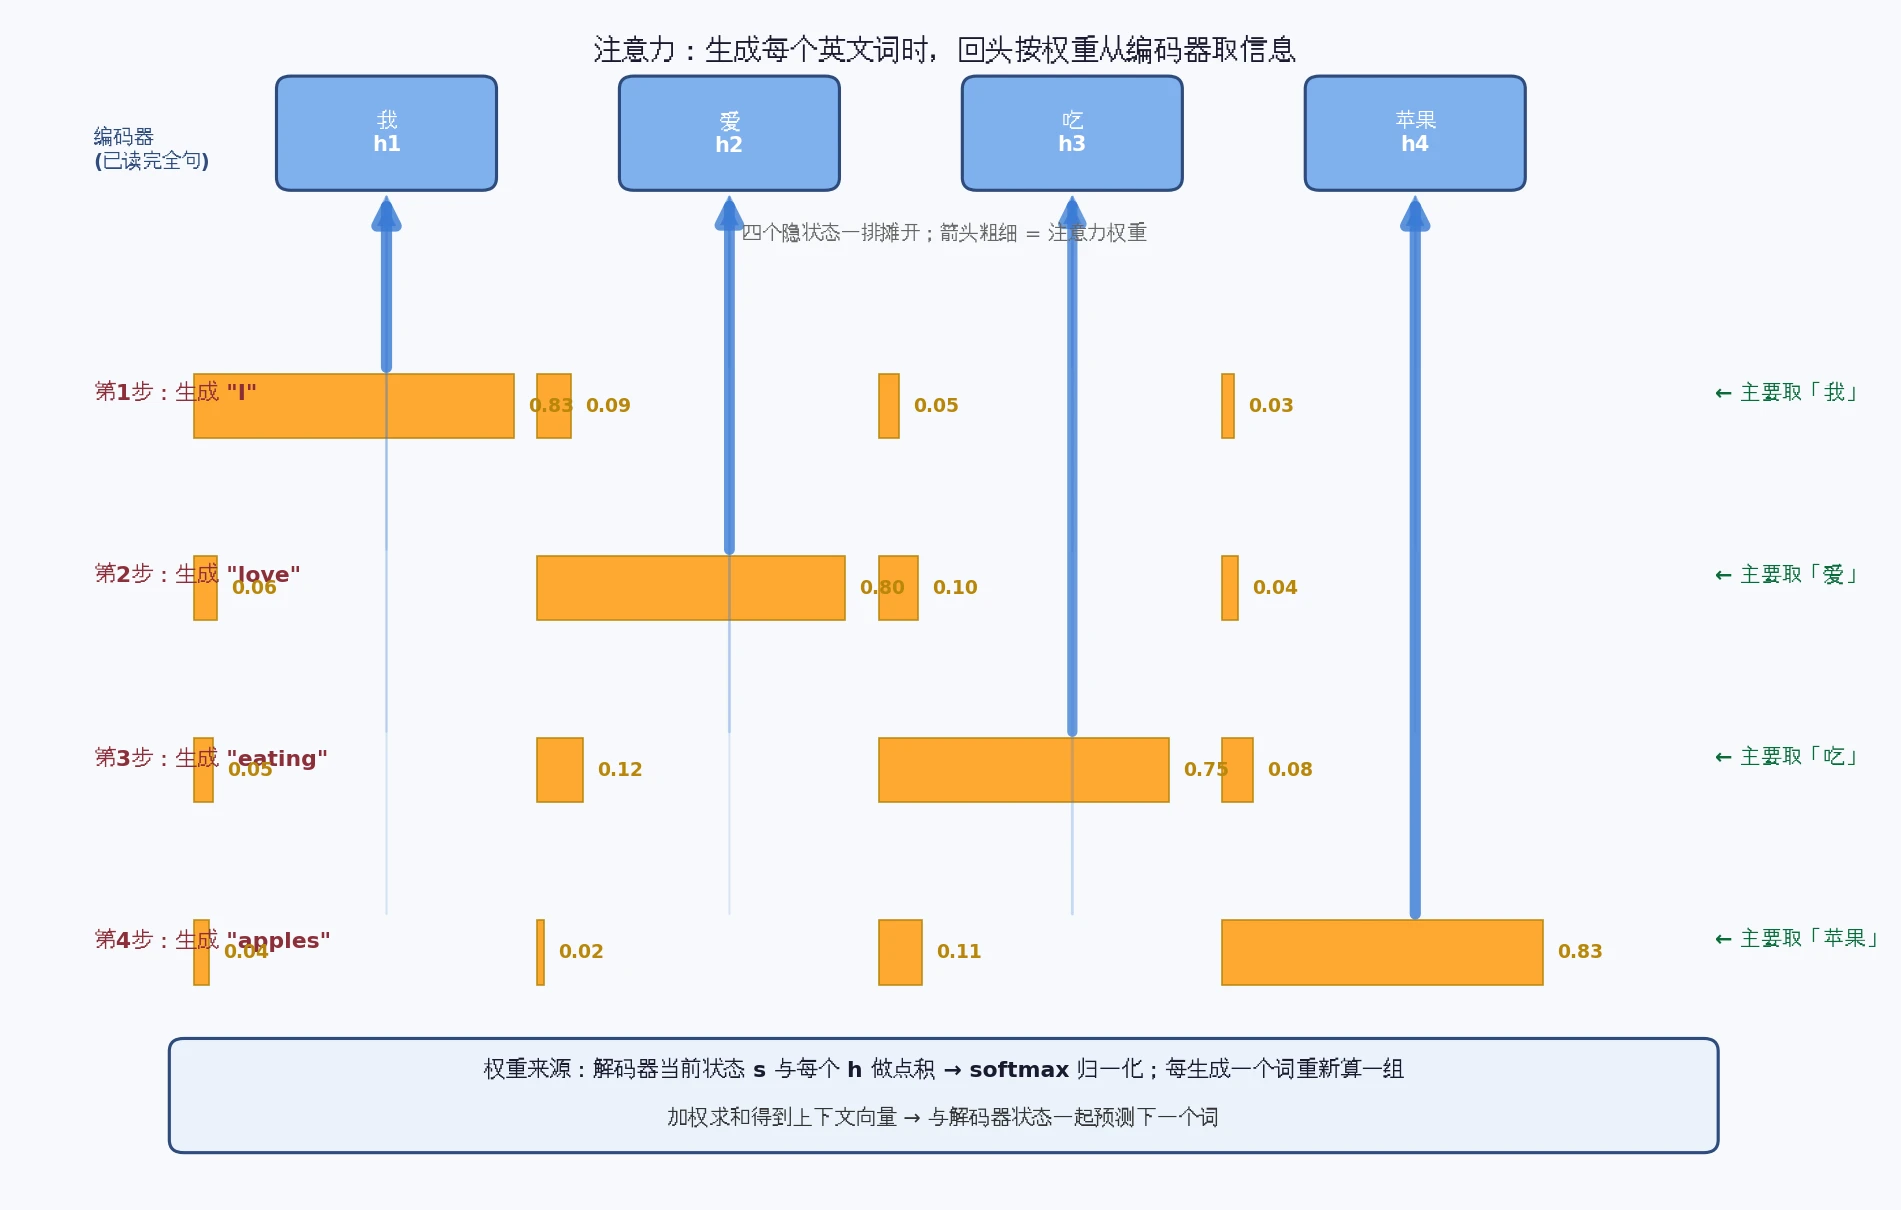
真实模型里的隐状态有几百维,这里压成 2 维,便于手算。假设编码器读完四个词后的隐状态是:
- 我:
- 爱:
- 吃:
- 苹果:
解码器走到生成 “苹果” 这一步,设用于计算注意力的前一状态为 。用最简单的点积打分。真实论文的打分网络更复杂,点积足够展示流程:
对 2、1、3、5 做 softmax。e 的幂分别是 7.39、2.72、20.09、148.41,合计 178.61,归一化后:
权重和为 1。这一步的上下文向量:
0.83 的权重落在「苹果」上,上下文向量接近「苹果」的隐状态。这个向量会和解码器状态一起参与词预测,但仅凭上下文向量不能推出 “apples” 一定是最高分,最终概率还取决于解码器参数和此前生成的词。生成 “I” 时会重新计算另一组权重,在这个例子中可设计为将较大权重分配给「我」。每一步解码都有各自的上下文。Bahdanau 论文标题中的 align 指软对齐:注意力权重可表示源词位置与目标词生成步骤之间的软对应关系。论文中的英法权重热力图展示了这种对应关系。
仍然存在的顺序处理限制
按 2014 年 9 月的预印本时间线,RNN 按顺序读句子,LSTM 通过门控改善长距离依赖的学习,seq2seq 用编码器-解码器做翻译,注意力让解码器能访问所有编码器状态。Bahdanau 的注意力工作随后于 ICLR 2015 正式发表。当时我将注意力理解为连接 RNN 编码器和解码器的辅助结构。
RNN 的计算依赖仍然存在:第 步必须等第 步完成后才能开始。同一序列的时间步无法并行,序列长度增加时,循环部分的计算路径随之增加,GPU 难以在时间维度发挥并行能力。注意力的打分和加权可在各编码器位置上并行计算,但 RNN 部分仍然串行。注意力让解码器直接访问所有编码器状态;编码器状态本身仍由 RNN 逐步计算,长距离依赖的问题只是得到缓解。
2017 年的 Attention is All You Need 只保留注意力机制。顺序信息从哪里来,逐词生成如何进行?后面再写一篇文章说一下我的理解。
本篇参考的资料
- Sequence to Sequence Learning with Neural Networks(Sutskever et al., 2014):编码器-解码器结构,「整句话压成一个固定向量」的设计出自这里。
- Neural Machine Translation by Jointly Learning to Align and Translate(Bahdanau et al., 2014):注意力机制的原始论文,打分、softmax、加权求和三步与软对齐热力图出自这里。
- On the Properties of Neural Machine Translation: Encoder-Decoder Approaches(Cho et al., 2014):长句 BLEU 分数随句长下降这一观察的原始出处,Bahdanau 论文开头引用的就是它。
- Understanding LSTM Networks(colah’s blog, 2015):LSTM 门控的图解,本篇对门和细胞状态的理解来自这篇。
- Visualizing A Neural Machine Translation Model(Jay Alammar, 2018):seq2seq 与注意力的图解,编码器-解码器之间的信息通路示意来自这篇。
