
22 年 ChatGPT 3.5 刚推出时,我做过一个接入代码仓库的 PR 审阅工具,团队同学反馈不错。继续研究后发现,当时模型能力有限。除目标明确、耦合较少的任务,例如单元测试和类型文件转换外,它难以显著改善研发流程。
后续因业务调整,我主要尝试将 LLM 用于私域业务场景。年初调到新成立的出海业务后,我重新评估研发助手。当前模型在部分能力上接近研究生或博士,Agent 框架也在持续演进,因此可以重新验证研发助手在研发流程中的适用场景。
经过团队访谈,目前先验证以下三个场景:
- 出海团队成员来自不同团队,对原有代码不熟悉,阅读代码耗时较长。
- 国际化迁移遗留了语言、货币、时间等硬编码技术债,治理规模大、耗时长。
- 大仓 PDA 设备上的功能目前均为 Native 实现。此前计划将其重构为动态化,但受人效限制未能推进;从整体效率和质量看,仍有迁移需求。
场景 1:帮助团队理解 Native 项目
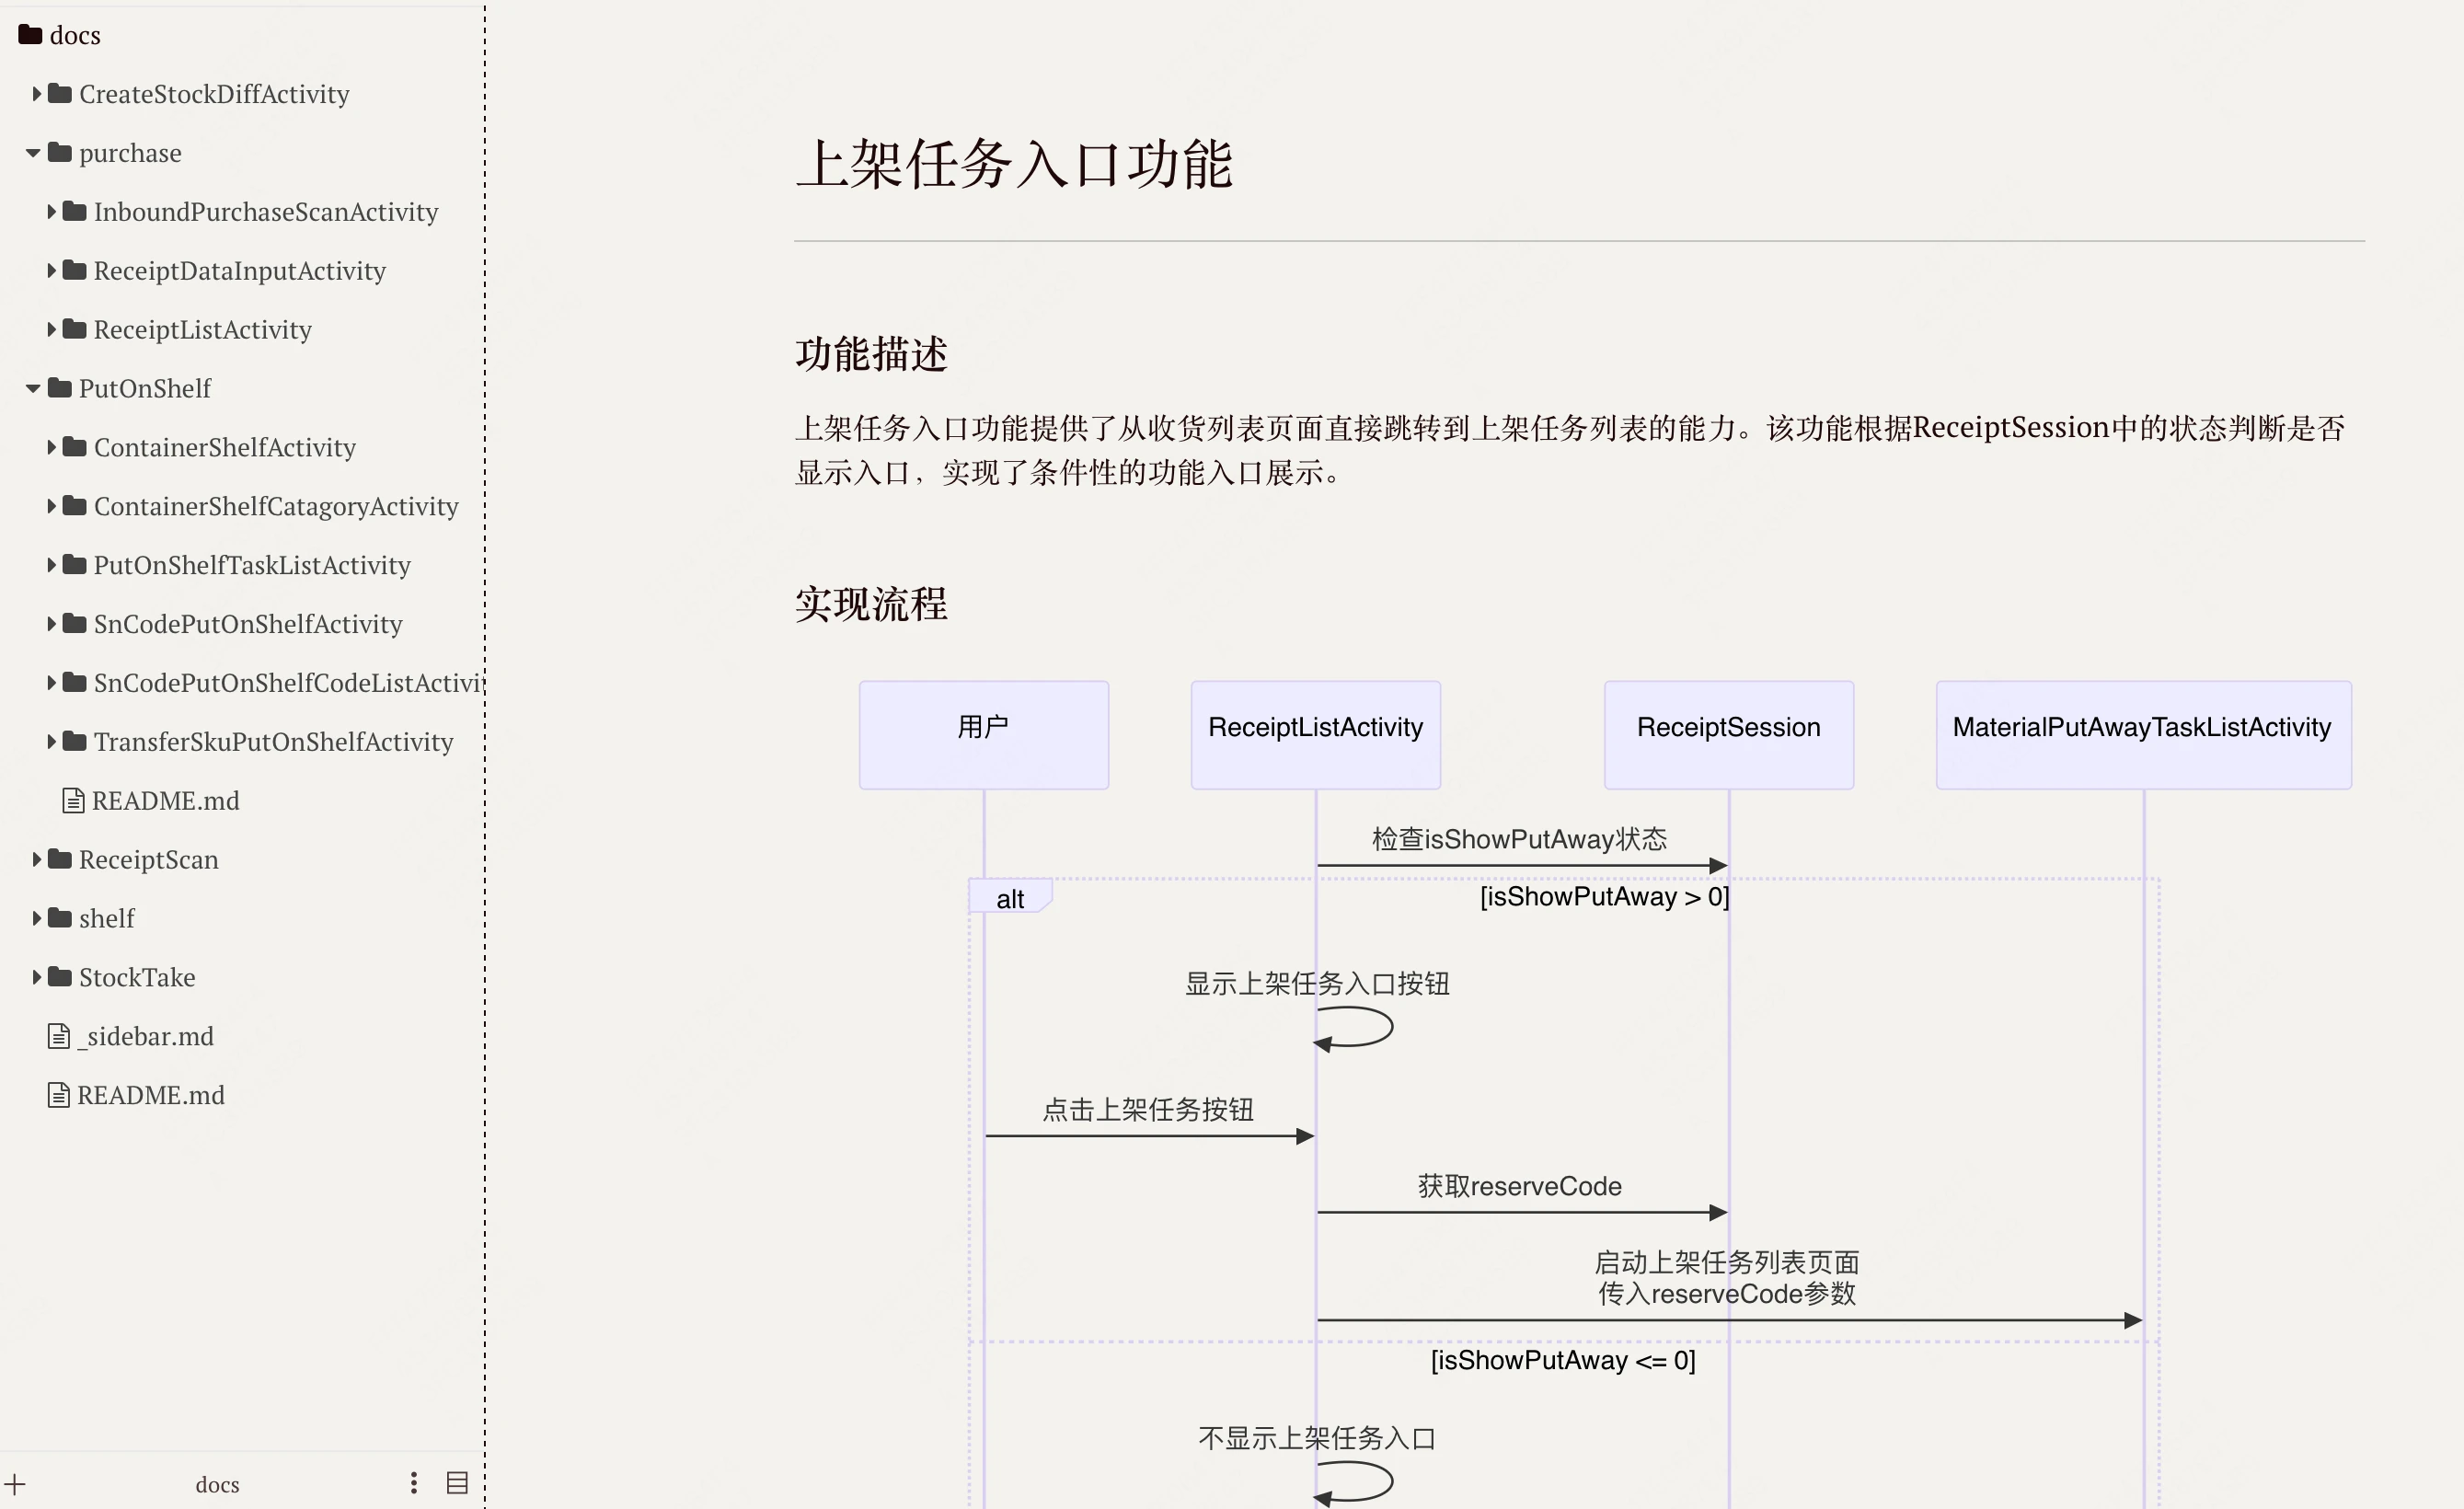
社区产品 https://deepwiki.org/ 已覆盖这类需求。我用了两天时间让它运行 Native 项目。它对基本流程和关键代码的识别结果较准确,如下图所示。
场景 2:识别国际化迁移遗留问题
这个场景的规则相对确定,上下文耦合较小。工程侧需要遍历代码仓库并按规则识别问题。
执行时,主要问题是规则覆盖范围难以确认。因此先让 AI 汇总问题并分为几十类,对无法确认归属的问题单独标注,再由 RD 制定处理方案。
场景 3:将 Native 项目迁移为动态化实现
采用 planning-execute 架构时,约 1500 行的 Activity 项目可以完成迁移,功能可用;UI 样式仍需调整。
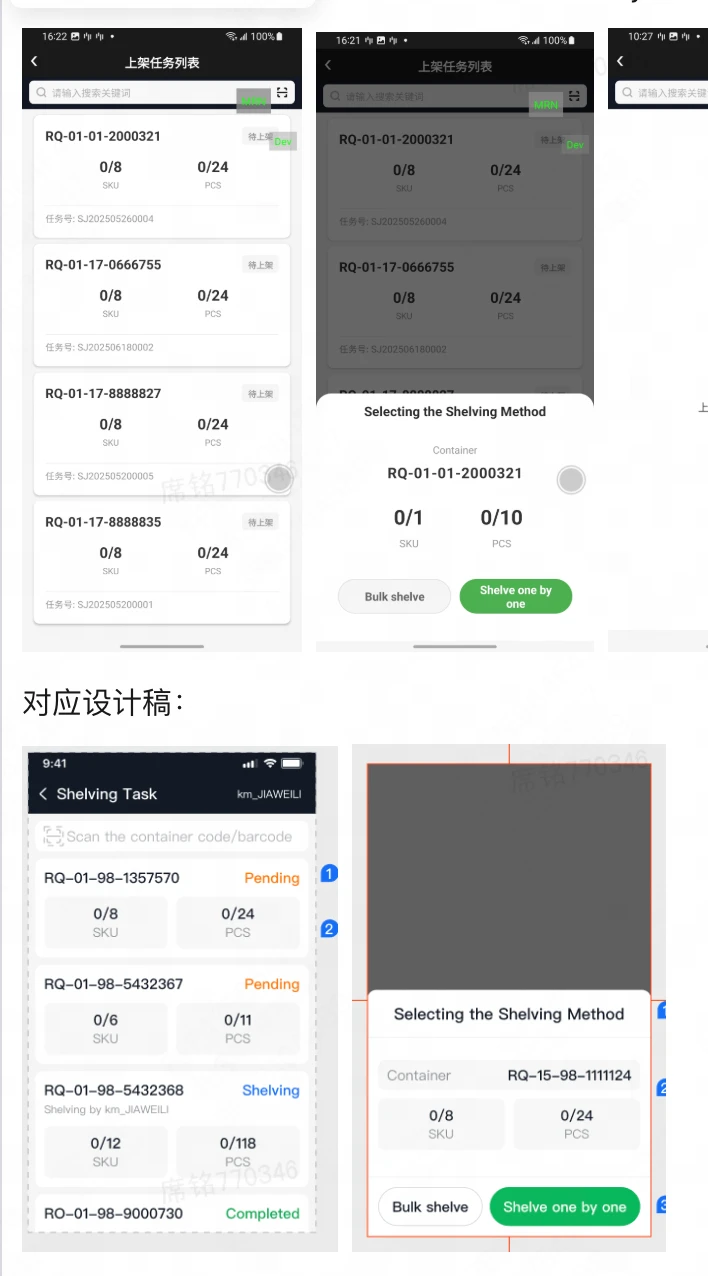
迁移约 4000 行的项目时,出现以下问题:
- 部分功能丢失。
- 部分组件有
className,但没有对应的style。 - 一次通过率低,人工介入成本高。
- 通过 MCP 召回组件库时,结果不准确。
功能和样式问题可以通过限制规划阶段的单个任务规模来处理。
任务拆分需要合理,并提供足够的反馈机制,以改善一次通过率。
组件库召回属于复杂问题中 Disorder 类的问题,还需要进一步分析和判断。
