
本文是「V2R:AI 迁移多智能体实战」系列第 4 篇(收尾篇)。系列目录:
- 2026
- 07-05 V2R Studio 架构:一个不写代码的编排大脑
- 07-12 一个页面的迁移之旅:S0-S4 流水线
- 07-19 门禁不经过 LLM:确定性信任链
- 07-26 越用越强:知识库、模型路由与盯盘仪表盘(本篇)
上一篇结尾留了两件事:信任链每跑一轮留在 artifacts/ 里的十几种 JSON,怎么沉淀成知识,怎么聚合成一张人能盯的盘。这篇把它们讲完,外加一个前几篇一直挂着没展开的话题:模型路由。三件事指向同一个目标,让系统随着使用变强,同时让人始终抓得住重点。
知识库:入库即须带证据
门槛做在两处。第一处在 schema:evidence 数组非空,条目才能落盘,证据分七类(source-analysis、verified-migration、e2e-pass、human-calibration、upstream-doc、code-review、fixture-validation),每条必须带非空 ref。第二处在 lint:draft 转 validated 必须至少一条 strong 证据,strong 指 source-analysis、verified-migration、e2e-pass、human-calibration 四类,这条规则(KL-05)进 pnpm verify 机器拦截。lint 规则集是从 v2r-agent 的二十几条里挑子集定稿的,共十条,含冲突检测(同栈同类两条 validated 抢同一个主匹配键报 error)和 failed 计数偏高的复核规则。stats 三个计数器(uses、verified、failed)禁手写,只允许收割器更新,failed 高的规则会被 lint 标出来复核。schema 里还有几条沿用 v2r-agent 的纪律:文件名即主键,条目 id 必须和相对路径一致;组件映射的 props 逐键 transform 走冻结枚举,需要计算的转换表达式过白名单 AST 静态校验,不允许任意代码;项目特定信息只进 projects/ 和按栈划分的数据目录,genericity lint 保证它渗不进通用包。
沉淀经验的规范上还有一条:knowledge/ 是独立 git 仓库,收割器是唯一写者。对话 CLI 里的写请求(比如派 CC 调研一条新映射)经消息通道投递给收割器,写前先 git pull --rebase。并发写坏库这个坑在设计期就按掉了。
光有门槛只能保证库里没有水货,保证不了库会长大。库长大靠 calibrate:每次人工裁决不只解决当次问题,还要沉淀成 pattern。机制是一个脚本一次沉淀,脚本里写清裁决依据(哪次修复实证、谁拍板、和同病的哪个先例归一),经收割器通道入库,出来就是 validated 条目。首批试点推进中,这类脚本已经沉淀了几类 pattern,举三个脱敏后的例子。
第一类是视觉修法。一个标签类组件的视觉问题修了两轮,第二次实证是同一个根因,于是不再在页面层治标,把修法本身沉淀成 pattern,后续页面命中直接套用。第二类是样式层叠陷阱:构建工具的分层样式机制叠上组件库的未分层样式,utility 类会静默失效,表现是 class 在、规则在、计算样式纹丝不动。两个不相干的实例同病归一,沉淀成一条覆写纪律:组件库类名元素上的定位布局一律用内联样式,批量覆写走页面级 CSS,utility 只用于没有库竞争的普通元素。第三类最说明方向:页面级密度。密度知识原本挂在一个表单类组件的条目上,转码遇到自拼表单页时不命中,被打回。裁决把密度从组件条目提升为 pattern 级横切规则:两层 Provider 缺一不可,默认所有转码页适用。
第三类的意义超出它本身。库里的知识不只会变多,还会改变形态:组件条目回答「这个组件怎么映射」,横切规则回答「这一类页面都遵守什么」。从条目到规则的提升由人的裁决触发,机器负责守住证据门槛。例外的处理在另一条路上:规则遇到反例不推翻,记 counter_examples 细化适用范围。整个循环画出来是这样:
这套机制对不对,里程碑里有可核对的口径:知识库 uses/verified 逐批增长,人工干预率逐批下降。
模型路由:四种活配三档模型
第二篇派活链路里提过路由表,这篇把背后的成本账算清楚。系统里的活分四种,推理深度和频率差别很大,配三档模型:
- 调查分析(读代码、提取事实)用 glm-5.3-flash。这是高频活,普查和逐页调查都要大量读文件,单次推理浅,用旗舰模型是浪费。
- 转码干活(按计划逐文件写 React)用 glm-5.3。这是质量敏感活:转码质量直接决定修复循环的轮次,在这里省 token,会在一轮一轮的修复里加倍还回去。
- 复杂规划(页面级迁移规划)用 kimi-3。一页一次,量小但错不起:计划错了,后面每个文件的转码跟着错。这是整批活里最重的一次推理,值得用最强的一档。kimi-3 返回计划草案后,由 pi 的确定性代码做标准化和校验再落库。
- 输出标准化不用模型,确定性代码优先,glm-5.3-flash 兜底。格式归一是确定性问题,能用代码就不用模型。
路由的实现是 model profile 三元组,核心代码五十来行:模型名经 argv 的 --model 传给工人进程;端点和鉴权经 spawn 环境变量注入;入库的配置文件只存环境变量名,token 本体不落任何文件。这是 token 纪律:仓库里能搜到的只有变量名,泄漏面只剩进程环境。spawn 参数另有一道黑名单,剥掉调用方夹带的 --model 等协议 flag,模型只以 model-router 为准,防止哪个节点自作主张换模型。model-router 是通用包,源码里没有任何领域字样,genericity lint 保证它不被项目污染。pi 自己做输出归一化时的 flash 调用,复用同一套 profile 和环境变量约定,全仓只有一种接模型的方式。
成本侧还有一道闸,和第三篇讲的修复轮次护栏并列:CC 每个 result 帧带 usage,按页累计,超阈值升级人工。轮次护栏防死循环,成本护栏防烧钱,谁先触发都算停。第一篇里一个单元连发 42 次 file_list 空调用、600 秒没人管,这次的对应物就是这道闸:用量越界,系统自己停下来叫人。
仪表盘:可信度不靠口头汇报
信任链产生的数据散在 artifacts/ 的十几种 JSON 里:文件级账本、行级 line-map、门禁快照、工单、token 用量、人工干预记录。要回答「哪些页面迁了、哪里有风险、卡在哪」,只能逐个 cat,或者靠Agent口头汇报。口头汇报是另一种自证:报告人挑重点,听的人没法核对。所以要有一个看板。
形态是本地 Web 应用,pnpm studio 起一个本地 server(:5175)加 React 前端,watch 现场目录和项目配置目录、节流约 2 秒重建数据。数据层是新增的通用包 report-model,一组 loader 各管一种数据源:run 的 meta.json、节点执行记录 nodes/*.json、文件级账本与行级 line-map、inbox 和 done 两处的工单文件、usage.json、delivery.json、人工干预记录。每个 loader 逐字段 optional,旧 run 缺文件记 warning 上浮,不报错。聚合层做三件事:run 归到项目(最长项目名前缀匹配,匹配不上进「未归属」桶)、页面全集推导(只读扫描 profile 声明的源仓页面目录,所以未启动的页面也在盘上)、信任阶梯推导。产出一份聚合 JSON,前端五个视图都读它。错误处理按降级设计:某个项目的 profile 解析失败或源仓路径不存在,这个项目降级显示,不阻断其他项目;watch 出异常就保留最后一次成功的 model。首版裁剪也写进了设计:不做静态快照导出、不做人工验收录入、不做多用户,先把盯盘这件事做扎实。
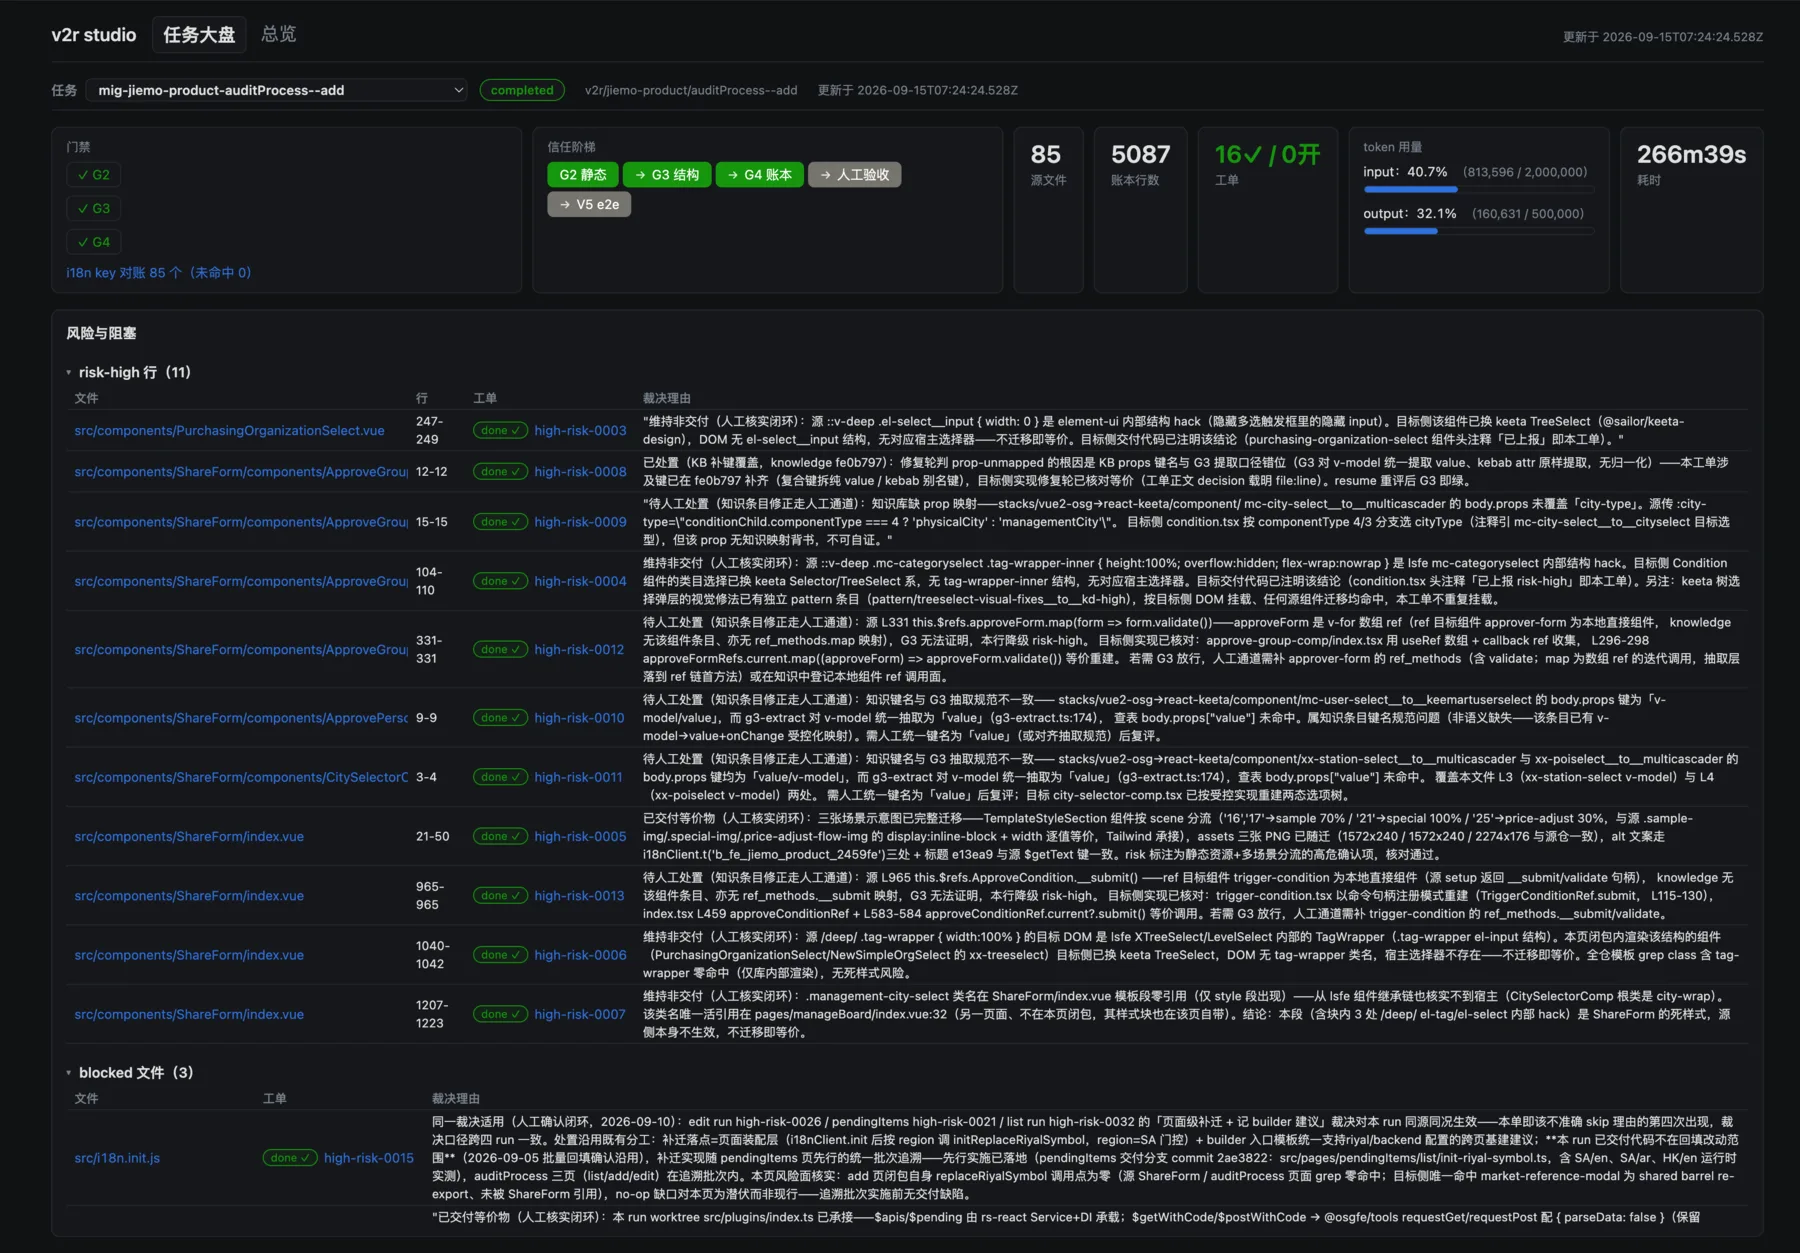
五个视图:总览(页面 × 迁移状态的矩阵,加 token 用量对配额的仪表)、Run 详情(节点执行时间线、门禁结果下钻、账本表)、风险与信任阶梯(risk-high 行和 blocked 文件清单,每条挂裁决理由)、工单(inbox 置顶,done 可检索)、成本(多 run token 消耗对比)。
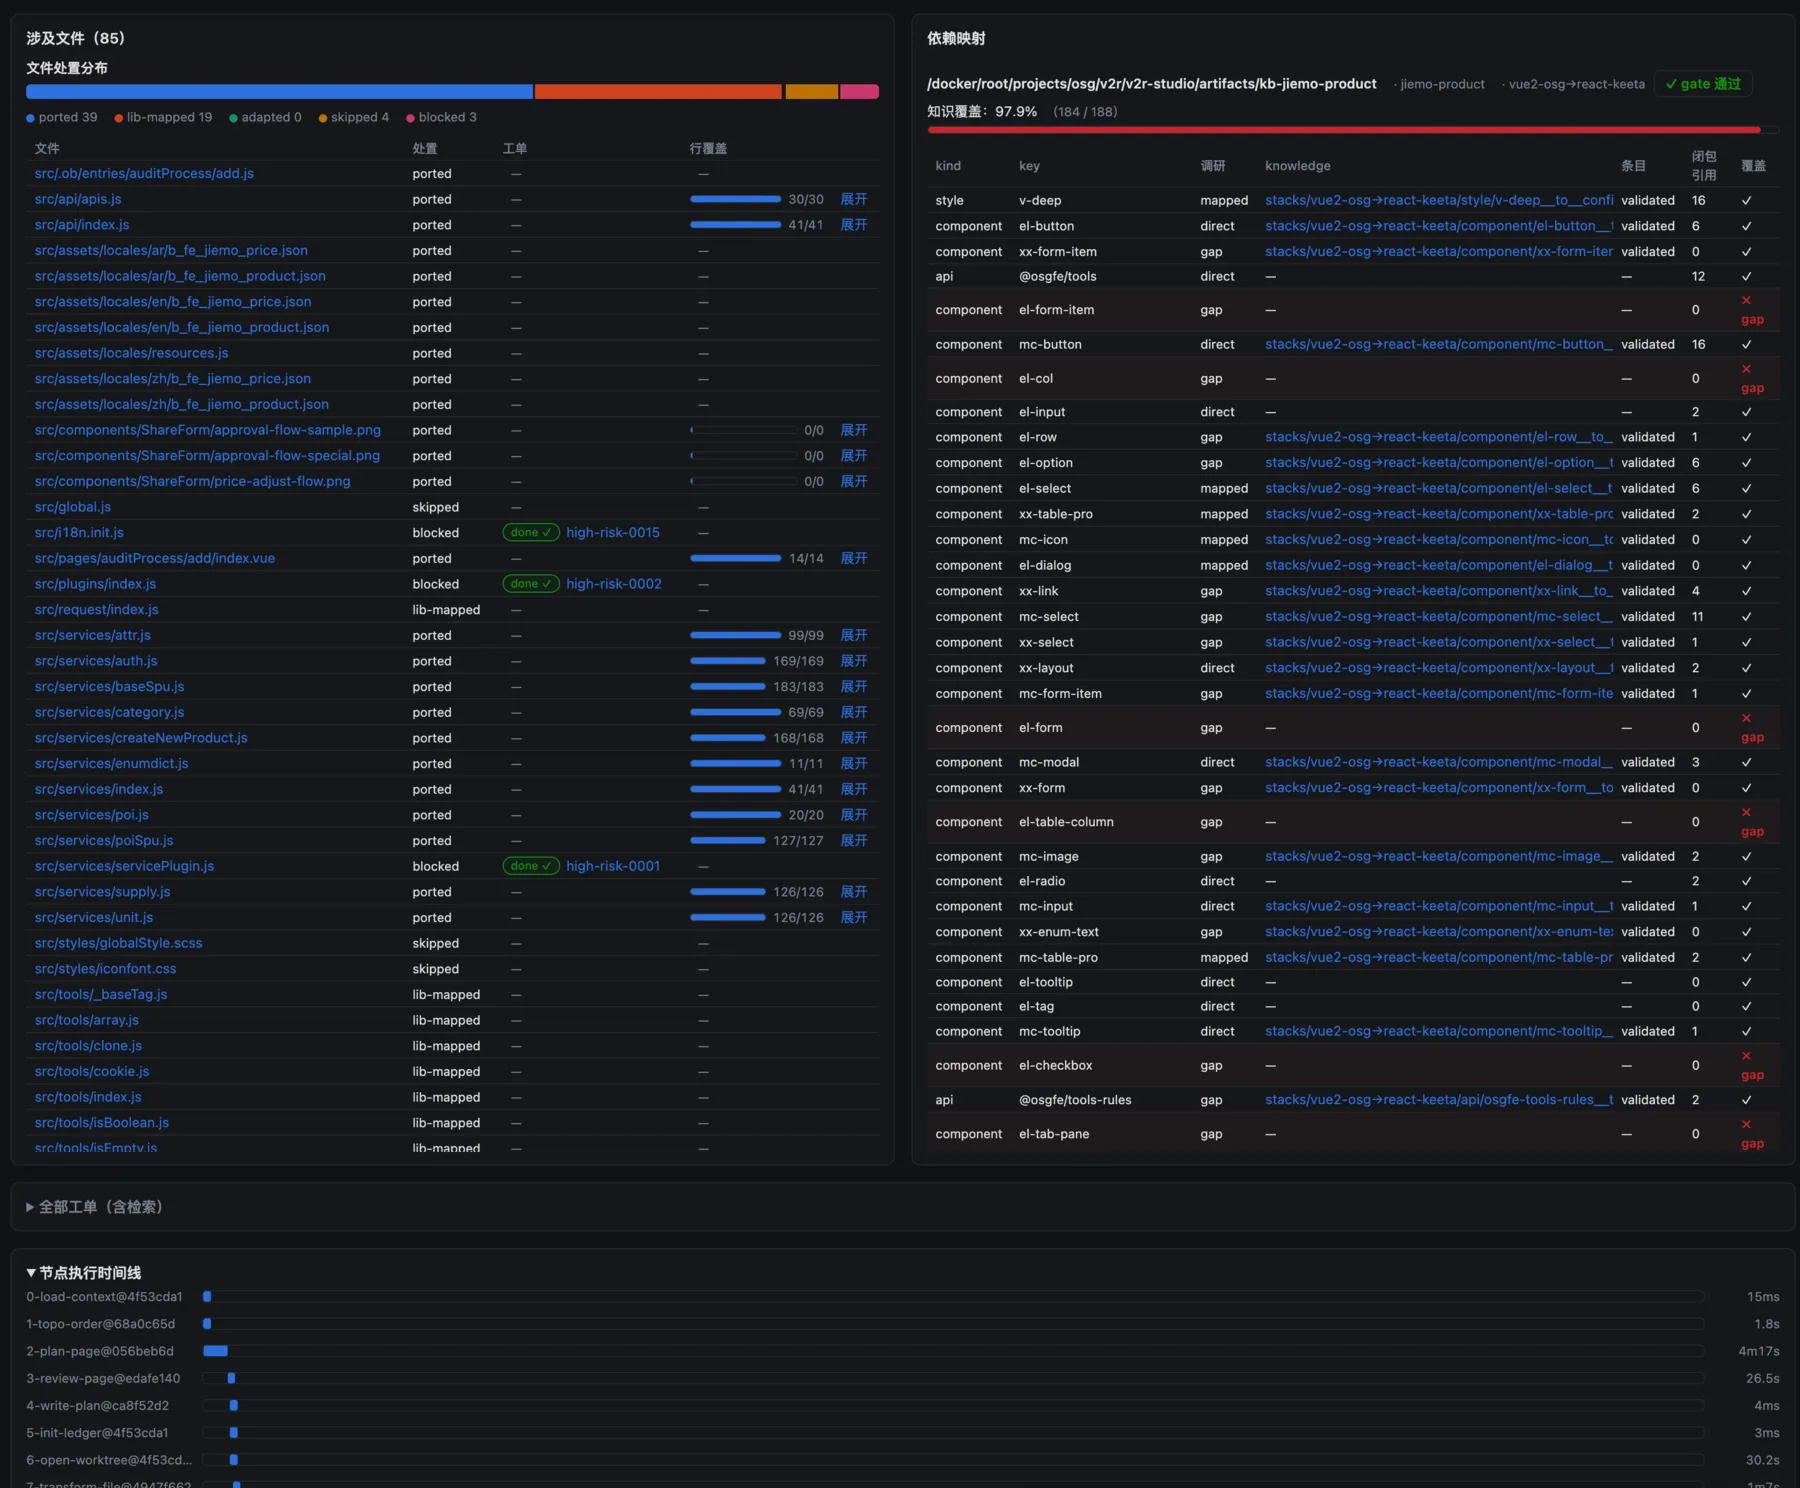
设计里有几条纪律和全系列一脉相承。纯只读:首版没有任何写操作,没有鉴权,没有数据库,工具写盘等于零。盯盘工具出 bug,最坏结果是看错,不可能是改坏。人工验收不进盘:视觉验收没有数据源,信任阶梯上人工验收那一层显示为灰色的「未覆盖」缺口,不隐藏。这是上一篇那条原则在界面上的落点:缺口本身是信息。机器门禁全绿不等于信任到顶,盘的作用是让信任停在哪一层一眼可见,而不是把边界藏起来。
收尾:每个反馈环都换成代码、证据和留痕
系列走完,回头看这五篇。第一篇里 v2r-agent 死于三个反馈环同时断开:verify 环的环境噪声淹没信号,KB 环没有事实源,repair 环不消化错误反馈。v2r-studio 做的事可以概括成把每个环都换掉:verify 环换成 S0 负控制、scoped 门禁和结构对账;KB 环换成普查先行、证据准入和 calibrate 沉淀;repair 环换成结构化喂回、逐字节判重和轮次成本双护栏。判定不经过 LLM,事实源只读由机器强制,每一步落盘可恢复。
这一篇的三件事是同一个思路的延伸:知识库让经验可积累,模型路由让成本可预期,仪表盘让系统的真实状态对人可见。三件里没有任何一件在让模型更聪明,模型还是那三个公开模型,会换代,也随时可换。变的是环绕模型的系统:账本如实记,缺口如实露,判不了的地方如实停下来叫人。
写这篇时,首个试点批次还在推进,知识库的条目数和仪表盘都还在增长。大家给的反馈是越用越强,等批次收口时知识库的 uses/verified 增长曲线,和人工干预率的下降曲线会有较明显的变化。
